Модуль math предоставляет доступ к математическим функциям, определяемым стандартом языка Си. Как правило, все функции модуля math возвращают значения вещественного типа.
Возвращает True если значения a и b равны с заданной точностью.
Параметры:
rel_tol – относительная погрешность: максимально допустимая разница между a и b относительно максимального значения их модулей; задается в процентах, например, для погрешности в 5% rel_tol=0.05;
abs_tol – абсолютная погрешность: минимально допустимая разница между a и b; как правило, используется для сравнения с нулевым значением.
Результат функции эквивалентен:
abs(a-b)<=max(rel_tol*max(abs(a),abs(b)),abs_tol)
Пример:
>>> math.isclose(5.0012,5.001,rel_tol=0.001)# 0.0002 < 0.0050012, до 3-х знаковTrue
Пример использования модуля приведен в Листинге 11.1.1.
Листинг 11.1.1 - Пример использования модуля math | скачать
1importmath 2 3# Гипотенуза прямоугольного треугольника с катетами a и b 4a,b=4,3 5print(math.hypot(a,b))# 5.0 6print(math.sqrt(a**2+b**2))# 5.0 7print((a**2+b**2)**0.5)# 5.0 8 9# Площадь круга10r=111print(math.pi*r**2)# 3.1415926535897931213# Вычисление площади треугольника по сторонам и углу между ними14a,b,alpha=3,4,9015print(a*b*math.sin(math.radians(alpha)))# 5.01617# Округление чисел18print(round(-4/3,2),round(4/3,2))# -1.33, 1.3319print(round(-4/3),round(4/3))# -1, 120print(int(-4/3),int(4/3))# -1, 121print(math.ceil(-4/3),math.ceil(4/3))# -1, 222print(math.floor(-4/3),math.floor(4/3))# -2, 123print(math.trunc(-4/3),math.trunc(4/3))# -1, 124print(math.isclose(1/3,0.333,abs_tol=0.001))# True25print(math.isclose(1/3,0.333,abs_tol=0.0001))# False2627# Степень и логарифмы28print(math.log(math.exp(2)))# 2.029print(math.factorial(5))# 120
Модуль random реализует генератор псевдослучайных чисел (ГПСЧ).
Случайность - проблема для компьютерной техники, поскольку все компьютеры являются цифровыми, и как следствие, детерминированы. Если дать компьютеру одни и те же инструкции, будет получаться один и тот же результат. Получается, что математически невозможно сгенерировать по-настоящему случайные числа, используя компьютер, однако довольно просто сгенерировать псевдослучайные числа. В отличие от случайных чисел одни и те же псевдослучайные могут быть сгенерированы раз за разом.
Псевдослучайные числа обладают определенными характеристиками:
сгенерированная последовательность не должна повторяться;
числа в последовательности должны быть равномерно распределены на определенном промежутке.
Примеры последовательностей:
плохие последовательности:
33333333333333333333 (все числа одинаковы);
01234567890123456789 (отсутствует случайность);
13253912425112815234 (неравномерно распределена);
28460982486422514862 (много четных чисел);
хорошие последовательности:
69120428572919253192;
62534197802164589509;
18523457952102109764;
90648315276146019756.
Для инициализации ГПСЧ требует определенное целое число (т.н. инициализатор), определяющее будущую генерируемую последовательность. При этом в целом нет возможности узнать зависимость между этим числом и получаемой последовательностью.
Практически все функции модуля основаны на функции random(). Для генерации чисел используется алгоритм «Вихрь Мерсенна», который лишен многих недостатков, присущих другим алгоритмам генерации (малый период, предсказуемость, легко выявляемая статистическая зависимость и др.). При этом данный алгоритм не является криптостойким (в данном случае, теоретически возможно «предсказать» их генерацию), поэтому не должен использоваться для задач, связанных с информационной безопасностью (например, для криптографии, шифрования и т.д.).
Первая функция не потокобезопасна, но работает несколько быстрее.
Пример использования модуля приведен в Листинге 11.1.2.
Листинг 11.1.2 - Пример использования модуля random | скачать
1importrandom 2 3random.seed(100) 4 5# Случайное число от 1 до 10 6print(random.randint(1,10))# 3 7 8# Случайное нечетное число от 1 до 10 9print(random.randrange(1,11,2))# 71011# Случайное вещественное число от 0 до 112print(random.random())# 0.454927004514021351314# Случайное вещественное число от -10 до 1015print(random.uniform(-10,10))# 5.4156761131804421617# Список из 5 случайных целых чисел [1, 100]18A=[random.randint(1,100)foriinrange(5)]1920print(A)# [91, 51, 94, 45, 56]2122# Список из 10 неповторяющихся целых чисел из отрезка [0, 99]23A=random.sample(range(100),10)24print(A)# [33, 6, 84, 82, 26, 42, 29, 39, 98, 22]2526# Случайный элемент из последовательности27nums_0_to_5=list(range(5))28print(random.choice(nums_0_to_5))# 42930# Перемешиваем список31random.shuffle(nums_0_to_5)32print(nums_0_to_5)# [2, 1, 3, 4, 0]
Последовательность data должна содержать по крайней мере 2 значения, иначе возбуждается исключение StatisticsError. xbar и mu - средние значения, если равны None, вычисляются автоматически.
Последовательность data должна содержать по крайней мере 2 значения, иначе возбуждается исключение StatisticsError. xbar и mu - средние значения, если равны None, вычисляются автоматически.
Пример использования модуля приведен в Листинге 11.1.3.
Листинг 11.1.3 - Пример использования модуля statistics | скачать
Абстрактный класс-информация о временной зоне. Используется классами time и datetime для хранения информации о часовом поясе или летнем/зимнем времени)
Все экземпляры данных классов являются немутирующими (неизменяемыми).
Классы time или datetime могут быть «наивными» или «осведомленными»:
«наивный» (англ. Naive) или «неосведомленный»: не содержит информацию о часовых поясах (временных зонах), летнем/зимнем времени и представляет «чистую» дату/время, которую можно интерпретировать так, как это понадобится в приложении;
«осведомленный» (англ. Aware): знает и содержит информацию о часовых поясах (временных зонах), летнем/зимнем времени, однозначно определяя дату/время.
Naive-вариант проще в использовании и может использоваться в приложении, если нет необходимости учитывать часовые пояса или летнее/зимнее время.
Возвращает количество дней в дате по пролептическому (расширенному до момента введения) григорианскому календарю, например, date(2,1,1).toordinal()==366.
Возвращает текущу дату и время, соответствующую ordinal значению дней в пролептическом григорианском календаре; например: datetime.fromordinal(366)#0002-01-0100:00:00; время и tzinfo не устанавливаются.
EST (англ. Eastern Standard Time, Североамериканское восточное время);
и др.
Экземпляр класса-потомка tzinfo может быть передан в конструктор объектов типа datetime и time; при этом атрибуты объектов находятся в местном времени, а tzinfo позволяет найти отклонение от заданного часового пояса.
Возвращает отклонение местного времени от UTC (в минутах), с учетом как часового пояса, так и летнего/зимнего времени. Если отклонение не известно, должен возвращать None.
Большинство реализаций содержит два варианта:
returnCONSTANT# фиксированное отклонение# илиreturnCONSTANT+self.dst(dt)# фиксированное отклонение + летнее/зимнее время.
Возвращает отклонение для летнего/зимнего времени (англ. Daylight Saving Time) от UTC (в минутах); если отклонение не известно, должен возвращать None.
Возвращает наименование (сроку) временной зоны для datetime-объекта dt (например, 'GMT', 'UTC', 'EDT', 'MSK'); если наименование не известно, должен возвращать None.
Возвращает отклонение местного времени от UTC (в минутах), с учетом как часового пояса, так и летнего/зимнего времени. Если отклонение не известно, должен возвращать None.
Возвращает datetime-объект, составленный из строки date_string по формату format.
Функция strftime() в Python базируется на аналогичной функции языка Си strftime() и поддерживает соответствующие спецификаторы (коды) формата.
В Таблице 11.1.6 приведены некоторые значения кодов формата.
Таблица 11.1.6 - Коды формата (в строке format) в функциях strftime() и strptime()
Код
Описание
Пример
%a
Сокращенное название дня недели *
Thu
%A
Полное название дня недели *
Thursday
%b
Сокращенное название месяца *
Aug
%B
Полное название месяца *
August
%c
Представление даты и времени *
ThuAug3014:08:30
%d
День месяца (1—31)
30
%H
Представление часов в 24-х часовом формате
15
%I
Представление часов в 12-ти часовом формате
03
%j
День в году (001-365)
215
%m
Номер месяца (01-12)
08
%M
Минуты (00-59)
14
%p
Обозначение AM или PM *
PM
%S
Секунды (00-61)
12
%U
Номер недели, первый день недели — воскресенье (0—53)
15
%w
Номер дня недели, начиная с воскресенья (0—6)
4
%W
Номер недели, первый день недели — понедельник (0—53)
20
%x
Представление даты *
08/30/12
%X
Представление времени *
14:35:08
%y
Год, последние две цифры
12
%Y
Год, полная запись
2012
%Z
Название или аббревиатура временной зоны
GMT
%%
Символ процента
%
* используется текущая локаль. Для того, чтобы отобразить наименования на русском, необходимо предварительно переключиться на русскую локаль (см. модуль locale).
Подробнее формат и поведение функций strftime() и strptime() описаны в справке.
Общий пример использования классов модуля datetime приведен в Листинге 11.1.4.
Листинг 11.1.4 - Пример работы с датой/временем | скачать
1importdatetime 2 3# Приветствие в зависимости от времени суток 4t1=datetime.datetime.now().time() 5hours=t1.hour+1 6if6<=hours<=10: 7print("Доброе утро!") 8elif10<hours<=18: 9print("Добрый день!")10else:11print("Доброй ночи!")12print()1314# Местное и UTC-время15print("Местное и UTC-время")16d1=datetime.datetime.utcnow()17d2=datetime.datetime.now()18td=d1-d219print(d1.strftime("%d/%m/%Y %H:%M"),"|",d1)# 23/12/2015 00:14 | 2015-12-23 00:14:07.28645420print(d2.strftime("%d/%m/%Y %H:%M"),"|",d2)# 23/12/2015 03:14 | 2015-12-23 03:14:07.28645821print("Разница = {}\n".format(abs(td)))# Разница = 3:00:00.0000042223# Время до события: datetime, timedelta24d1=datetime.datetime.strptime("14/06/2018 18:00","%d/%m/%Y %H:%M")25d2=datetime.datetime.now()26td=d1-d22728print("До 1 матча ЧМ 2018 по футболу осталось")29print(" 1-й матч: {}".format(d1.ctime()))# Thu Jun 14 18:00:00 201830print(" Сейчас: {}".format(d2.strftime("%a %b %d %H:%M:%S %Y")))31print(" Осталось: {} дн. {} ч. {} мин.".32format(td.days,td.seconds//3600,td.seconds//60%60))3334# -------------35# Пример вывода:3637# Доброй ночи!38#39# Местное и UTC-время40# 23/12/2015 00:14 | 2015-12-23 00:14:07.28645441# 23/12/2015 03:14 | 2015-12-23 03:14:07.28645842# Разница = 3:00:00.00000443#44# До 1 матча ЧМ 2018 по футболу осталось45# 1-й матч: Thu Jun 14 18:00:00 201846# Сейчас: Wed Dec 23 03:14:07 201547# Осталось: 904 дн. 14 ч. 45 мин.
Модуль time содержит функции для работы с временем. Большинство функций является аналогом соответствующих функция языка Си (синтаксис и возможности могут различаться в зависимости от используемой платформы).
Основные термины и особенности:
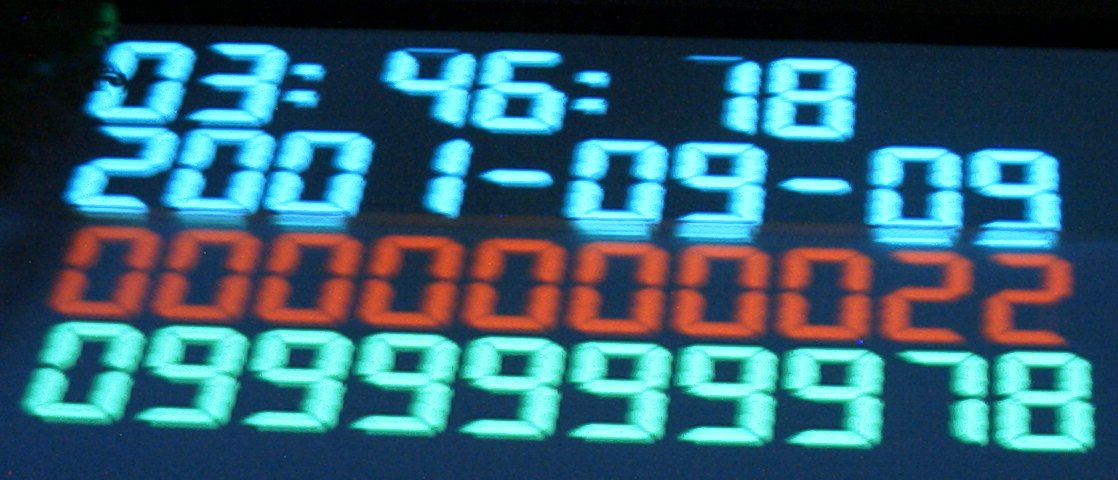
эра (англ.Unix Epoch): количество секунд, прошедших с полуночи (00:00:00 UTC) 1 января 1970 года (четверг) (Рисунок 11.1.1);
Рисунок 11.1.1 - UNIX-время, соответствующее 1 000 000 000 секунд. Дата отмечалась в Копенгагене 9 сентября 2001 г. в 01:46:40 [6]
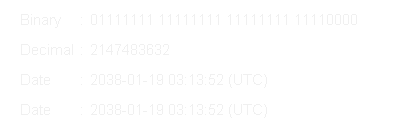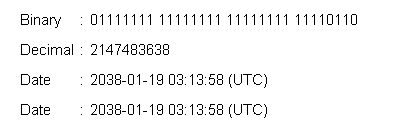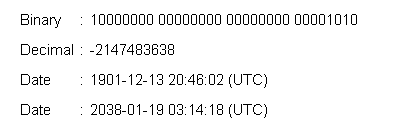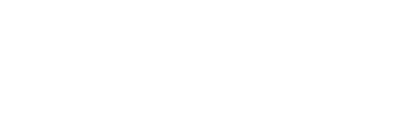
функции могут не работать с датами вне промежутка от начала эпохи до 2038 г. (проблема 2038 года, Рисунок 11.1.2);
Рисунок 11.1.2 - Пример, показывающий сброс даты (в 03:14:08 UTC 19 января 2038 года) [7]
Приостанавливает поток выполнения программы на seconds секунд (аргумент может быть вещественным - долей секунды).
Пример использования модуля приведен в Листинге 11.1.5.
Листинг 11.1.5 - Пример работы с датой/временем | скачать
1importtime 2 3# Приложение имитирует индикатор прогресса во время установки приложения 4print("Добро пожаловать в инсталлятор! Нажмите <ENTER> для продолжения...") 5input() 6 7print(time.ctime(60*60*24*365*45))# Sun Dec 21 03:00:00 2014 8 9sec_start=time.perf_counter()10foriinrange(100):11print("#",end="",flush=True)12# "Засыпаем" на 50 мс.13time.sleep(0.05)1415if(i+1)%10==0:16print(" {:3}%".format(i+1))17sec_end=time.perf_counter()1819print("Программа успешно установлена за {:.2f} с.".format(sec_end-sec_start))2021# -------------22# Пример вывода:2324# Добро пожаловать в инсталлятор! Нажмите <ENTER> для продолжения...25#26# Sun Dec 21 03:00:00 201427# ########## 10%28# ########## 20%29# ########## 30%30# ########## 40%31# ########## 50%32# ########## 60%33# ########## 70%34# ########## 80%35# ########## 90%36# ########## 100%37# Программа успешно установлена за 5.01 с.
Сторонний пакет pytz содержит данные о всех временных зонах согласно базе данных часовых поясов (или «базе данных Олсона»).
Пример использования пакета приведен в Листинге 11.1.7.
Листинг 11.1.7 - Пример работы с пакетом pytz | скачать
1importpytz 2importdatetime 3 4ALIGN_FIX=20 5 6# Список идентификаторов находится в pytz.all_timezones или common_timezones 7# for tz in pytz.all_timezones: 8# print(tz) 9# print(pytz.common_timezones)1011# Временная зона MSK12tz_msk=pytz.timezone("Europe/Moscow")13dt1=datetime.datetime.now(tz_msk)1415print("{:>{}}: {}".format("Московское время",ALIGN_FIX,dt1))16print("{:>{}}: {}".format("UTC-время",ALIGN_FIX,dt1.astimezone(pytz.utc)))17print("{:>{}}: {}".format("Отклонение от UTC",ALIGN_FIX,dt1.utcoffset()))18print("{:>{}}: {}".format("Сдвиг лето/зима",ALIGN_FIX,dt1.dst()))1920# Временные зоны можно использовать из модуля pytz или21# создать собственные, используя datetime.timezone22tz_bj=datetime.timezone(datetime.timedelta(hours=8),"China/Beijing")23tz_pa=pytz.timezone("Europe/Paris")24tz_wa=pytz.timezone("US/Pacific")25print("{:>{}}: {}".format("Пекин",ALIGN_FIX,dt1.astimezone(tz_bj)))26print("{:>{}}: {}".format("Париж",ALIGN_FIX,dt1.astimezone(tz_pa)))27print("{:>{}}: {}".format("Нью-Йорк",ALIGN_FIX,dt1.astimezone(tz_wa)))2829# -------------30# Пример вывода:3132# Московское время: 2015-12-25 15:05:18.225371+03:0033# UTC-время: 2015-12-25 13:27:57.220009+00:0034# Отклонение от UTC: 3:00:0035# Сдвиг лето/зима: 0:00:0036# Пекин: 2015-12-25 21:27:57.220009+08:0037# Париж: 2015-12-25 14:27:57.220009+01:0038# Нью-Йорк: 2015-12-25 05:27:57.220009-08:00
Модуль locale предоставляет доступ к набору локалей и реализован на базе соответствующего модуля языка Си. Механизм локалей позволяет взаимодействовать с национальными особенностями системы (языковыми, культурными и т.д.).
Устанавливает локаль для категории category в значение locale, если оно не равно None. В качестве категории может использоваться любое предопределенное значение, например locale.LC_ALL (все настройки), locale.LC_TIME (настройки отображения времени) и т.д.
Python предоставляет множество модулей для работы с платформой и операционной системой (ОС), которые поддерживают как зависимые, так и независимые от конкретной платформы функции.
К наиболее часто используемым модулям/пакетам относятся:
Возвращает наименование кодировки по умолчанию для ОС (используется для преобразования из/в Юникод); например, 'utf-8' для Mac OS X или 'mbcs' для Windows.
Объект (словарь), содержащий значения переменных среды (окружения).
Если значение не найдено, возбуждается исключение KeyError. Также существует альтернативная функция os.getenv(name), возвращающая None в случае отсутствия значения.
Пример: os.environ['HOME'] или os.getenv('HOME') вернет домашний каталог пользователя, а при параметре LOGNAME - имя текущего пользователя.
Реализовано как возбуждение исключения SystemExit.
Аргумент arg - код возврата командной строки (по умолчанию 0, т.е. «успешное завершение»), большинство ОС поддерживает числа 0-127, где отличное от 0 значение свидетельствует об ошибке.
Пример использования ряда указанных функций приведен в Листинге 11.1.9.
Листинг 11.1.9 - Пример работы с операционной системой | скачать
1importsys 2importos 3importplatform 4importsubprocess 5 6# Создадим файл с информацией о платформе/ОС и откроем его 7# в редакторе по умолчанию 8 9if__name__=="__main__":1011# Путь (относительный) к файлу с данными12# Создание файла будет происходить в рабочей директории13data_filename="data.txt"1415# Создаем файл16withopen(data_filename,"w",encoding="utf-8")asfh:17fh.write("Файл с данными: {}\n\n".format(data_filename))1819fh.write("os.environ")20fornameinsorted(os.environ):21fh.write(" {} = {}\n".format(name,os.environ[name]))2223fh.write("\nsys.copyright = {}\n\n".format(sys.copyright))2425fh.write("sys.version_info = {}\n\n".format(sys.version_info))26fh.write("sys.path = {}\n\n".format(sys.path))27fh.write("sys.argv = {}\n\n".format(sys.argv))28fh.write("sys.byteorder = {}\n\n".format(sys.byteorder))29fh.write("sys.getfilesystemencoding() = {}\n\n".30format(sys.getfilesystemencoding()))31fh.write("sys.maxsize = {}\n\n".format(sys.maxsize))3233fh.write("platform.uname() = {}".format(platform.uname()))3435# Открываем получившийся файл в приложении по умолчанию36ifplatform.system()=="Windows":37os.startfile(data_filename)38else:39subprocess.run(["xdg-open",data_filename])
Возвращает строку, содержащую путь к рабочему каталогу (каталогу файловой системы, который используется для нахождения файлов, указанных только по имени либо по относительному пути).
Регулярные выражения (англ. Regular Expressions) - это компактная форма записи (шаблон, маска или паттерн) представления о коллекции строк. Гибкость и мощь регулярных выражений обусловлена тем, что единственное регулярное выражение может представлять неограниченное число строк, подходящий под заданный шаблон.
Регулярные выражения используются для достижения четырех основных целей:
Проверка
Проверка соответствия фрагментов текста некоторым критериям. Например, наличие символа обозначения валюты и последующих за ним цифр, проверка адреса электронной почты и т.д.
Поиск
Поиск подстрок, которые в том числе могут иметь несколько форм. Например, поиск 'pet.png', 'pet.jpg', 'pet.jpeg' или 'pet.svg', чтобы при этом не обнаруживались подстроки 'carpet,png' и подобные ей.
Замена
Замена всего, что совпадает с шаблоном, на указанную строку. Например, поиск подстроки 'устройствопередвижения,движимоемускульнойсилой' и замена подстрокой 'велосипед'.
Разбиение строк
Разбиение строки по точкам совпадения с шаблоном. Например, разбиение строки по ':' или '='.
Примечание
Для написания и отладки регулярных выражений удобно использовать онлайн-сервисы, например https://regex101.com, которые в том числе содержат библиотеку готовых выражений и могут генерировать код для различных языков программирования.
Большинство символов могут использоваться как литералы, однако некоторые имеют «специальное назначение» в языке регулярных выражений и потому должны экранироваться символом обратного слеша '\', когда они используются как литералы.
К специальным символам (также символам-джокерам или символам подстановки) относятся:
\ . ~ $ ? + * { } [ ] ( ) |
В пределах регулярных выражений можно также использовать большинство стандартных экранированных последовательностей языка Python, например, '\n', '\t' и др.
Поиск множества символов
Для поиска не конкретной последовательности символов, а некоторого их множества предназначены классы символов.
„[группа_символов]“
Соответствует любому одиночному символу, входящему в группа_символов. По умолчанию при сопоставлении учитывается регистр.
Пример:
выражение '[аеёиоуэюя]' позволяет найти все гласные буквы в строке;
выражение 'п[ое]л' даст совпадение для слов 'пел' и 'пол', но не найдет слова 'поел' или 'пил'.
„[^группа_символов]“
Соответствует любому одиночному символу, НЕ входящему в группа_символов. По умолчанию при сопоставлении учитывается регистр.
Пример:
выражение '[^аеёиоуэюя]' обнаружит все символы в тексте, кроме гласных букв.
„[первый-последний]“
Диапазон символов: соответствует одному символу в диапазоне от первый до последний.
Пример:
выражение '[0-9]' найдет все цифры тексте.
„.“ (точка)
Специальный знак '.' соответствует какому-либо одному знаку, кроме '\n'. Для поиска точки необходимо использовать экранирование: '\.'.
Пример:
выражение 'м.л' найдет в тексте 'мел', 'мул' и т.д.
„\w“
Соответствует любому алфавитно-цифровому знаку.
Пример:
выражение '\w1' найдет в тексте '11' или 'я1'.
„\W“
Соответствует любому символу, НЕ являющимся алфавитно-цифровым знаком.
„\s“
Соответствует любому пробельному символу (пробел, табуляция и др.).
„\S“
Соответствует любому знаку, НЕ являющемуся пробельным.
„\d“
Соответствует любой десятичной цифре.
Пример:
выражение '\d-й' найдет в тексте '1-й' или '2-й'.
„\D“
Соответствует любому символу, НЕ являющемуся десятичной цифрой.
Предупреждение
При использовании онлайн-сервисов будьте внимательны - некоторые не поддерживает Юникод в полном объеме, поэтому, например, выражение '\w' может не находить кириллицу в тексте. В Python данной проблемы нет.
Зачастую требуется не только найти слово по символам или группе символов, но и указать количество возможных повторений, для чего в регулярных выражениях используются квантификаторы.
Квантификаторы записываются после символа/строки/множества (Таблица 11.1.8).
В случае, когда необходим поиск подстроки с сохранением для дальнейшей обработки или выбор варианта поиска, регулярные выражения предлагают операции группировки '()' и выбора '|' соответственно.
Группировка
Группировка '()' преследует 2 цели: сгруппировать шаблон поиска (группировка) и использовать его в дальнейшем (группировка с сохранением или захватом).
Обращение к захваченной группе возможно:
по индексу: '\i', где i - это порядковый номер группы;
по имени: '\k<Название>', если группа была именованой.
„(часть_выражения)“
Захватывает, соответствующие выражения и присваиваем им нумерацию, начиная с 1.
Пример:
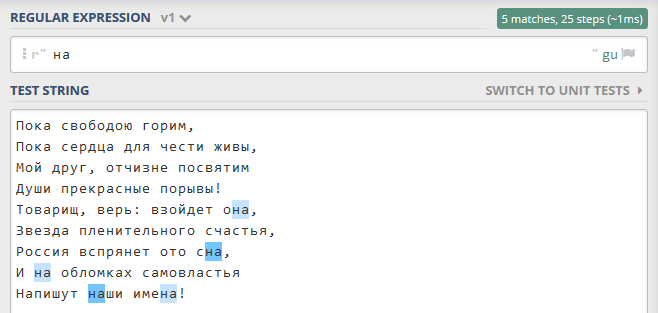
выражение '(\w+)\s+\1' выполнит в тексте поиск повторяющихся слов, разделенных пробельным символом (пример упрощен); при этом первое слово будет захвачено в отдельную группу под номером 1 (Рисунок 11.1.6 (а)).
Выделяет соответствующую часть выражения в именованную группу. Именованные группы удобно использовать в длинных или сложных регулярных выражениях.
Пример:
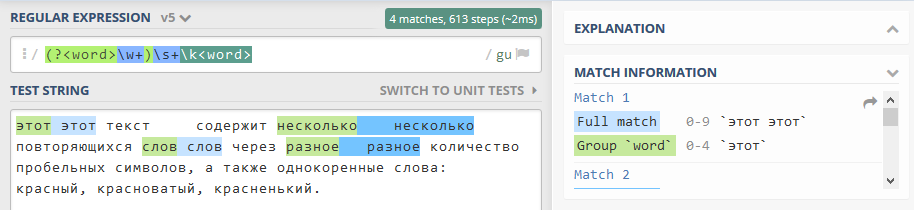
выражение '(?<word>\w+)\s+\k<word>' выполнит в тексте поиск повторяющихся слов, разделенных пробельным символом (паттерн очень упрощен); при этом первое слово будет захвачего в отдельную группу под именем word (Рисунок 11.1.6 (б)).
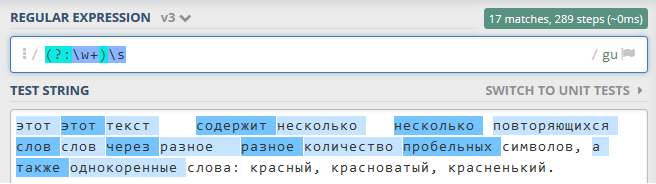
выражение '(?:\w+)\s' выполнит в тексте поиск слов, отделенных пробельным символом; при этом слово НЕ будет захвачено в отдельную группу (Рисунок 11.1.6 (в)).
Операция выбора позволяет захватить одно из нескольких выражений в качестве результата поиска.
„выражение1|выражение2|выражение3“
Соответствует любому элементу, разделенному вертикальной чертой '|'.
Пример:
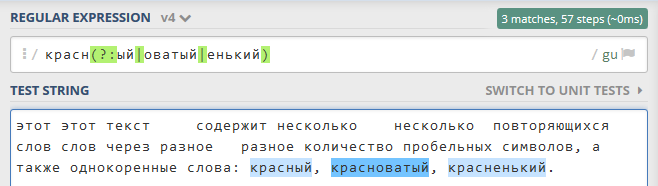
выражение 'красн(?:ый|оватый|енький)' найдет в тексте слова 'красный', 'красноватый', 'красненький'; при этом окончание не будет захвачено в группу (Рисунок 11.1.6 (г)).
Для работы с регулярными выражениями в Python доступен стандартный модуль re.
Предварительно Python выполняет компиляцию регулярного выражения - перевод заданного выражения во внутренний формат. В виду этого существует 2 способа работы:
Если предполагается однократная проверка, достаточно использовать функции модуля re. При этом во время вызова функции, произойдет компиляция регулярного выражения и дальнейший поиск соответствий.
Если проверка будет осуществляется не один раз, эффективным будет предварительно один раз скомпилировать выражение (получив специальный объект класса re.regex), а затем использовать его методы.
В коде регулярные выражения обычно записываются в виде «сырых» строк (с префиксом r, подавляющих экранирование). Так, при поиске переноса строки удобнее указать r"\n" вместо "\\n", избежав необходимости дублировать экранирующий символ.
Механизм регулярных выражений в языке Python предоставляет возможность устанавливать флаги, влияющие на работу регулярных выражений. Обычно флаги устанавливаются при вызове функции re.compile().
Флаг включения многострочного режима. При этом '^' определяет начало, а '$' - окончание каждой строки (без этого режима, определяется соответствие до первого символа переноса строки).
Возвращает список строк всех неперекрывающихся совпадений, просматривая текст для поиска слева направо. Если в регулярном выражении используется группировка, она возвращается в списке в виде кортежа.
Возвращает строку string, в которой произведена замена всех неперекрывающихся совпадений с шаблоном pattern на строку repl. Если repl - функция, она вызывается для каждого совпадения.
Возвращает строку string, экранируя все символы кроме ASCII, чисел и '_'. Удобно использовать, если в регулярном выражении необходимо отследить часть, которая может являться специальным символом.
Возбуждается, когда строка, переданная в качестве регулярного выражения, содержит ошибки (например, нет парной скобки) или произошла ошибка во время компиляции или поиска вхождений.
Объект класса match содержит соответствия строки регулярному выражению и имеет ряд атрибутов.
Объекты данного типа всегда равны True, поэтому типовая проверка на вхождение может выглядеть следующим образом:
# Если необходимо первое вхождение...match=re.search(pattern,string)ifmatch:# Делать что-то с 'match'...# Если необходимо найти все вхождения...match=re.search(pattern,string)ifmatch:foreach_matchinre.finditer(pattern,string):# Делать что-то с 'each_match'...
Возвращает одну или несколько подгрупп совпадений (если аргумент один - строку, если несколько - кортеж).
Параметр может быть числом или строкой (в случае именованной группы).
Пример:
m = re.search(r"^(\w+) (\w+)", "Никлаус Вирт, ученый в области информатики")>>> m.group(0)# Все совпадение'Никлаус Вирт'>>> m.group(1)# Первая группа'Никлаус'>>> m.group(2)# Вторая группа'Вирт'>>> m.group(1,2)# 2 группы сразу('Никлаус', 'Вирт')
Пример работы с регулярными выражениями, используя функции и классы модуля re, приведены в Листингах 11.1.11 (а) и (б).
Листинг 11.1.11 (а) - Пример работы с регулярными выражениями (используя функции модуля re) | скачать
1importre 2 3# Необходимо найти все e-mail в заданном тексте 4 5# Данные шаблон сильно упрощен для понимания! 6# см. http://stackoverflow.com/questions/201323/ 7# using-a-regular-expression-to-validate-an-email-address 8EMAIL_REGEX=r"[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+[a-zA-Z]" 910text="""Это произвольный текст, в котором будет происходить поиск11адресов электронной почты (e-mail). Скажу сразу, что мой e-mail12ya@gmail.com; папы и мамы: papa@mail.ru и mama@yandex.ru, а также брата13brat@hotmail.com и даже моего любимого кота: pushok@rambler.ru."""1415# 1. Используя re.search() + re.finditer()16m=re.search(EMAIL_REGEX,text,re.MULTILINE)17ifm:18foriteminre.finditer(EMAIL_REGEX,text):19# 'item' - объект класса match20print("Найден e-mail: {}, позиция {}".format(item.group(0),21item.span()))22else:23print("Ни одного e-mail не найдено!")2425# 2. Используя re.findall()26res=re.findall(EMAIL_REGEX,text,re.MULTILINE)27iflen(res)>0:28foriteminres:# 'item' - строка29print("Найден e-mail: {}".format(item))30else:31print("Ни одного e-mail не найдено!")3233# -------------34# Пример вывода:35#36# Найден e-mail: ya@gmail.com, позиция (122, 134)37# Найден e-mail: papa@mail.ru, позиция (149, 161)38# Найден e-mail: mama@yandex.ru, позиция (164, 178)39# Найден e-mail: brat@hotmail.com, позиция (194, 210)40# Найден e-mail: pushok@rambler.ru, позиция (239, 256)
Листинг 11.1.11 (б) - Пример работы с регулярными выражениями (используя классы модуля re) | скачать
1importre 2 3# Необходимо найти все телефоны и их описание 4 5page="""http://минобрнауки.рф/контакты 6Минобрнауки России. Телефоны для связи. 7Справочная служба +7 (495) 539 55 19 8Факс +7 (495) 629 08 91 9"Горячая линия" +7 (499) 553 09 6310Общественная приемная +7 (499) 236 18 8311Контакты для представителей СМИ +7 (495) 629 92 1212Отдел государственной службы и кадров +7 (495) 629 36 42"""1314# 1. re.compile() + regex.finditer() + нумерованная группа15print("1. нумерованные группы")16PHONE_REGEX=r"^(.+?)\s+(\+7 \(\d{3}\) \d{3} \d{2} \d{2})$"17regex=re.compile(PHONE_REGEX,re.MULTILINE)18formatchinregex.finditer(page):19name,phone=match.group(1,2)20print("Наименование: '{}', Телефон: '{}'".format(name,phone))2122# 2. re.compile() + regex.finditer() + именованная группа23print("\n2. именованные группы")24PHONE_REGEX=r"^(?P<Наименование>.+?)\s+"\
25"(?P<Телефон>\+7 \(\d{3}\) \d{3} \d{2} \d{2})$"26regex=re.compile(PHONE_REGEX,re.MULTILINE)27formatchinregex.finditer(page):28name=match.group("Наименование")29phone=match.group("Телефон")30print("Наименование: '{}', Телефон: '{}'".format(name,phone))3132# 3. re.compile() + regex.finditer() + regex.groupdict()33print("\n3. regex.groupdict()")34formatchinregex.finditer(page):# regex уже был создан во 2-м пункте35# Словарь match.groupdict() содержит все именованные группы36print("Наименование: '{Наименование}', Телефон: '{Телефон}'".37format(**match.groupdict()))3839# -------------40# Пример вывода:41#42# Наименование: 'Справочная служба', Телефон: '+7 (495) 539 55 19'43# Наименование: 'Факс', Телефон: '+7 (495) 629 08 91'44# Наименование: '"Горячая линия"', Телефон: '+7 (499) 553 09 63'45# Наименование: 'Общественная приемная', Телефон: '+7 (499) 236 18 83'46# Наименование: 'Контакты для представителей СМИ', Телефон: '+7 (495) 629 92 12'47# Наименование: 'Отдел государственной службы и кадров', Телефон: '+7 (495) 629 36 42'
Функциональный стиль программирования - это подход, когда вычисления программируются путем комбинирования функций, а не последовательностью действий, как в императивном стиле программирования.
Основное преимущество такого подхода к программированию заключается в том, что при его использовании (теоретически) намного проще разрабатывать функции по отдельности и проще отлаживать функциональные программы. Также плюсом является, что функциональные программы не изменяют свое состояние, поэтому вполне возможно рассуждать об их функциях с математической точки зрения.
С функциональным программированием тесно связаны три понятия: отображение, фильтрация и упрощение.
В Python существует несколько функций поддерживающих данные концепции:
Применяет функцию function к каждому элементу итерируемого объекта iterable и возвращает результат.
Если аргументов iterable несколько, процесс продолжается аналогично до минимальной длины всех итерируемых объектов.
Функция map() работает аналогично соответствующему алгоритму с использованием цикла for, но, как правило, выполняется быстрее.
Пример использования функции map() приведен в Листинге 11.1.12.
Листинг 11.1.12 - Пример использования функции map() | скачать
1importmath 2 3# 1. Ввод нескольких чисел в одной строке 4a,b,c=map(int,input("Введите 3 числа через пробел: ").split()) 5print(a,b,c) 6 7# 2. Формируем список квадратов элементов 8values=list(range(6)) 9print(values)# [0, 1, 2, 3, 4, 5]1011# 2.1. Стандартный метод с использованием цикла for12squared=[]13forxinvalues:14squared.append(x**2)1516print(squared)# [0, 1, 4, 9, 16, 25]1718# 2.2. map19squared=list(map(lambdax:x**2,values))20print(squared)# [0, 1, 4, 9, 16, 25]2122# 3. Несколько итерируемых объектов в map: получаем список степеней чисел23powers=list(map(math.pow,values,[2,3,4]))24print(powers)# [0.0, 1.0, 16.0]
Применяет функцию function с 2-мя аргументами к каждому элементу последовательности iterable слева направо, аккумулируя и возвращая результат вычисления.
Дополнительный параметр initializer (при наличии) определяет начальное значение результата; если он не задан - используется первый элемент iterable.
Например:
reduce(lambdares,x:res+x,[1,2,3,4,5])# 15
определяет сумму списка, как ((((1+2)+3)+4)+5), где:
res - аргумент, накапливающий результат вычисления;
x - очередной элемент последовательности.
Пример использования функции reduce() приведен в Листинге 11.1.14.
Листинг 11.1.14 - Пример использования функции reduce() | скачать
1importrandom 2importfunctools 3 4# 1. Сумма и произведение чисел в списке 5random.seed(101) 6 7values=list(random.sample(range(-15,15),5)) 8print(values)# [3, 12, -9, 14, 2] 910# 1.1. Стандартный for11l_sum=012l_mult=113forvalueinvalues:14l_sum+=value15l_mult*=value1617# 1.2. reduce18l_sum_2=functools.reduce(lambdares,y:res+y,values)19l_mult_2=functools.reduce(lambdares,y:res*y,values)2021print(l_sum,l_mult)# 22 -907222print(l_sum_2,l_mult_2)# 22 -90722324# 2. Формирование строки из списка25strings="Болтовня ничего не стоит. Покажите мне код. Linus Torvalds".split()26# ["Болтовня", "ничего", "не", "стоит.", "Покажите", "мне", "код.",27# "Linus", "Torvalds"]28print(strings)2930# 2.1. Стандартный " ".join()31expr_1=" ".join(strings)3233# 2.2. reduce34expr_2=functools.reduce(lambdares,y:res+" "+y,strings)3536print(expr_1)37print(expr_2)